Large Language Modelle contra Fraud
Large Language Modelle contra Fraud: Wie das Forschungsprojekt SeLLMa ERP-Systeme sicherer macht
Das DFG-geförderte Forschungsprojekt SeLLMa unter der Leitung von Prof. Dr. Bernd Scheuermann der Hochschule Karlsruhe untersucht, wie Large-Language-Modelle (LLMs) zur Erkennung und Verifikation von Fraud in Enterprise-Resource-Planning-Systemen (ERP-Systemen) eingesetzt werden können. Im Fokus stehen die Erzeugung realitätsnaher synthetischer ERP-Daten durch LLM-basierte Softwareagenten, die Weiterentwicklung der Fraud-Erkennung durch die Kombination aus Datenanalyse und generativer KI sowie die Unterstützung der forensischen Analyse durch einen Chatbot. In Zusammenarbeit mit dem Industriepart- ner Pointsharp GmbH werden die Ansätze prototypisch umgesetzt und erprobt, um langfristig die Sicherheit von ERP-Systemen zu verbessern.
Ob Rechnungsprüfung, Materialbestellung oder Zahlungsabwicklung, moderne Unternehmen nutzen zur Verwaltung ihrer Geschäftsprozesse Enterprise-Resource-Planning-Systeme (ERP-Systeme). Solche Systeme bilden das digitale Rückgrat vieler Unternehmen. Doch genau dort, wo große Datenmengen und sensible Prozesse aufeinandertreffen, entstehen Risiken. Trotz vorhandener Berechtigungskonzepte können Mitarbeiter*innen sich selbst bereichern und dem Unternehmen durch diesen Betrug, im Fachbereich üblich als Fraud bezeichnet, erhebliche finanzielle Schäden zufügen.
Hier setzt das Forschungsprojekt SeLLMa (Sichere ERP-Systeme durch LLM-basierte Aufdeckung von Fraud) an. Es wird von der Deutschen Forschungsgemeinschaft (DFG) im Rahmen der Förderlinie Transfer HAW/FH PLUS gefördert. Diese Förderlinie richtet sich speziell an Hochschulen für Angewandte Wissenschaften und zielt darauf ab, wissenschaftliche Erkenntnisse gemeinsam mit Praxispartnern weiterzuentwickeln und in konkrete Anwendungen zu überführen. Im Projekt SeLLMa geschieht dies in enger Kooperation mit dem Anwendungspartner Pointsharp GmbH, einem europäischen Anbieter von Cybersecurity- und Identity-Management-Lösungen. Gemeinsam blicken die Hochschule Karlsruhe und die Pointsharp GmbH (ehemals SIVIS GmbH) auf eine langjährige Kooperation zurück. So wurden in vergangenen Forschungsprojekten unter anderem der Einsatz maschinellen Lernens zur Erkennung von Fraud sowie der Einsatz evolutionärer Algorithmen zur Erstellung und Optimierung von Rollen- und Berechtigungskonzepten erforscht.1 2
Während der dreijährigen Projektlaufzeit (01.01.2026 bis 31.12.2028) wird im Rahmen von SeLLMa gemeinsam untersucht, wie Large-Language-Modelle (LLMs) dazu beitragen können, Fraud besser zu erkennen. Ziel ist es, wissenschaftliche Erkenntnisse nicht nur theoretisch zu entwickeln, sondern sie direkt in praxisnahe Anwendungen zu überführen und damit ERP-Systeme nachhaltig sicherer zu machen. Für die Untersuchungen wird das ERP-System SAP S/4HANA des deutschen Softwarekonzerns und Marktführers SAP SE genutzt.
Problemstellung und Motivation
Fraud stellt für Unternehmen ein ernstzunehmendes Problem dar. Schätzungen zufolge gehen rund fünf Prozent des Jahresumsatzes durch solche betrügerischen Aktivitäten verloren. 3 Besonders kritisch ist, dass viele dieser Vorfälle innerhalb der Unternehmensgrenzen entstehen. ERP-Systeme dokumentieren dabei jede dieser Aktivitäten detailliert. Sie erzeugen riesige Datenmengen, die theoretisch ideale Voraussetzungen für die Fraud-Erkennung bieten. Dennoch bleibt Fraud oft unentdeckt oder wird erst spät erkannt. Dafür gibt es mehrere Gründe.
Ein zentrales Problem ist die Datenverfügbarkeit. Reale ERP-Daten sind hochsensibel und werden selten öffentlich zugänglich gemacht, auch aus Angst vor Reputationsverlust, sodass die Entwicklung geeigneter Technologien zur Erkennung von Fraud erschwert ist. Werden die Erkennungsverfahren hingegen auf synthetischen Daten entwickelt, ist zu beachten, dass diese häufig nicht realitätsnah genug sind. Dies erschwert die Übertragbarkeit der entwickelten Technologien auf reale Daten. Insgesamt fehlt es daher an einer soliden Grundlage für die Forschung in diesem Bereich.
Ein weiteres Problem ist, dass etablierte Technologien natürliche Grenzen mit sich bringen. Klassische Modelle des maschinellen Lernens können zwar Auffälligkeiten identifizieren, die eigentliche Verifikation, also die Klärung, ob tatsächlich Fraud vorliegt, bleibt jedoch ein komplexer Prozess. Dieser erfordert die Zusammenführung von Informationen aus zahlreichen Datenquellen, die in ERP-Systemen oft über viele Tabellen hinweg verteilt sind. Hinzu kommt, dass sich Betrugsmuster ständig verändern. Regelbasierte Systeme sind daher schnell überholt und auch datengetriebene Ansätze müssen kontinuierlich angepasst werden.
Vor diesem Hintergrund ergibt sich die Motivation für SeLLMa: Intelligente Technologien sind erforderlich, die Daten nicht nur analysieren, sondern auch im Kontext verstehen. Genau diese Fähigkeit, Sprache zu verstehen und Zusammenhänge herzustellen, machen LLMs zu einem vielversprechenden Werkzeug für die Fraud-Erkennung.
Ziele und Methoden
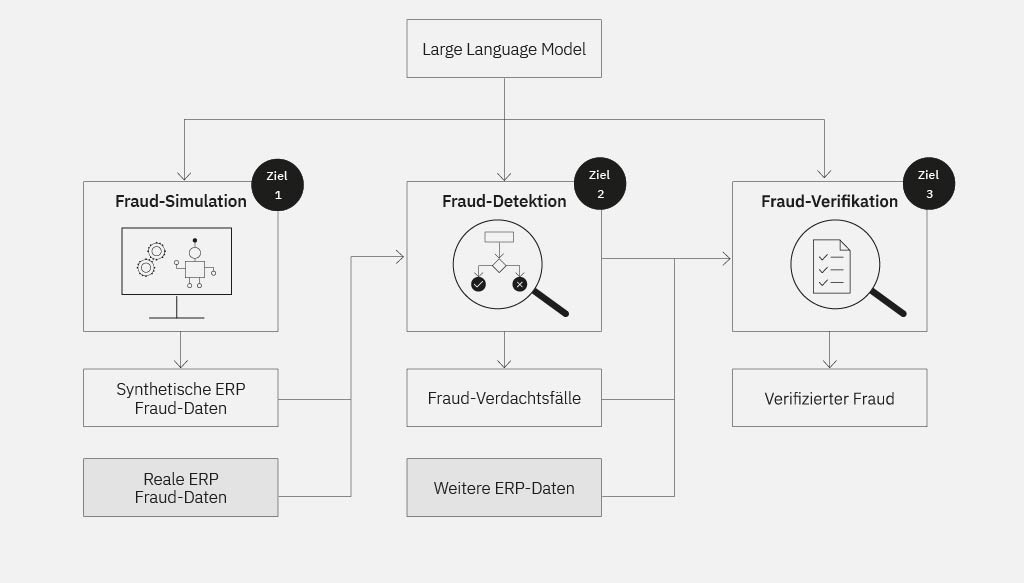
Das Forschungsprojekt SeLLMa verfolgt das Ziel, die Fraud-Erkennung in ERP-Systemen grundlegend zu verbessern und gleichzeitig deren Transfer in die unternehmerische Praxis zu ermöglichen. Im Mittelpunkt stehen drei zentrale Ziele (siehe Abbildung 2). Im Rahmen des Projekts sollen als erstes Ziel realitätsnahe ERP-Daten erzeugt werden. LLM-basierte Softwareagenten simulieren das Verhalten realer Mitarbeitender eines Unternehmens, die sowohl legitime als auch betrügerische Aktivitäten in ERP-Systemen ausführen. So entstehen synthetische, aber realitätsnahe Daten, die anschließend veröffentlicht werden sollen. Auf diese Weise können sowohl Forschende als auch praktische Anwender*innen die Datensätze nutzen, um eigene Verfahren zur Erkennung von Fraud zu entwickeln. Zusätzlich kann auf diese Weise eine gemeinsame Basis geschaffen werden, um die Leistungsfähigkeit der entwickelten Technologien zu vergleichen. Einzelne Aspekte dieses Ansatzes wurden bereits in zwei Konferenzbeiträgen einem wissenschaftlichen Fachpublikum vorgestellt. Dabei konnten die Vorteile von LLM-basierten Agenten bei der Automatisierung von Geschäftsprozessen praktisch demonstriert werden. Zudem wurde die Zuverlässigkeit des Ansatzes in einem Multi-Agenten-Szenario evaluiert. 4 5
Als zweites Ziel soll in SeLLMa die Eignung generativer KI zur Datenanalyse erforscht werden. Während Algorithmen des maschinellen Lernens vor allem strukturierte Daten auswerten, bieten LLMs die Möglichkeit, zusätzliche Kontextinformationen und textuelle Inhalte zu verarbeiten. Dadurch wird es möglich, typische legitime Geschäftsprozesse zu verstehen und Abweichungen von diesen zu erkennen. Zur Integration von zusätzlichem Kontextwissen, wie dem Ablauf von Geschäftsprozessen, der Struktur der bereitgestellten Daten oder historischen Fraud-Fällen, sollen verschiedene Methoden der Wissensbereitstellung evaluiert werden. Um die Ergebnisse der LLM-basierten Datenanalyse mit klassischen Verfahren des maschinellen Lernens zu vergleichen und Aussagen über die Eignung von LLMs zur Fraud-Erkennung treffen zu können, kann auf Ergebnisse aus früheren Projekten zurückgegriffen werden. Hier wurden Entscheidungsbäume zur Erkennung von Fraud eingesetzt und der Einfluss einzelner Attribute auf die Vorhersagegenauigkeit untersucht. 6
Das dritte Ziel des Forschungsprojekts betrifft die Verifikation von Verdachtsfällen. Während klassische Verfahren des maschinellen Lernens zur Fraud-Erkennung Datenpunkten eine Kategorie („Fraud“ oder „kein Fraud“) oder einen Wahrscheinlichkeitswert zuweisen, kann generative KI-Antworten in verständlicher Sprache erzeugen, die mögliche Erklärungen für einen Verdachtsfall liefern. Hierfür soll im Rahmen von SeLLMa ein Chatbot entwickelt werden, der Anwender bei der Analyse unterstützt. Über eine natürlichsprachliche Schnittstelle können Nutzer*innen Fragen stellen, während das System relevante Informationen aus dem ERP-System zusammenführt und verständlich aufbereitet. Dies reduziert den manuellen Aufwand erheblich und macht die Entscheidungsprozesse transparenter.
Ein konkretes Beispiel verdeutlicht den Mehrwert: Wird eine auffällige Zahlung erkannt, kann ein Chatbot bei der nun anstehenden Verifikation des Verdachtsfalls unterstützen. Mitarbeiter*innen können den Chatbot fragen: „Zeige mir alle Zahlungen an Lieferant X der letzten sechs Monate.“ Das System durchsucht daraufhin die relevanten ERP-Tabellen, kombiniert diese, erkennt Muster und gibt eine verständliche Zusammenfassung zur Verifikation des Verdachtsfalls aus. Was bisher Stunden manueller Recherche erforderte, geschieht so in Sekunden.
SeLLMa ist von Beginn an stark praxisorientiert. Die entwickelten Methoden werden nicht nur wissenschaftlich erforscht, sondern auch in Zusammenarbeit mit dem Projektpartner Pointsharp GmbH prototypisch umgesetzt. Ziel ist es, einen nachhaltigen Beitrag zur Sicherheit von ERP-Systemen zu leisten.
Quellen
1 Bundesministerium für Bildung und Forschung: KOEX, https:// www.forschung-it-sicherheit- kommunikationssysteme.de/ projekte/koex, letzter Zugriff: 04.05.2026.
2 Bundesministerium für Bildung und Forschung: AutoBer, https:// www.forschung-it-sicherheit- kommunikationssysteme.de/ projekte/autober, letzter Zugriff: 04.05.2026.
3 Association of Certified Fraud Examiners: Occupational Fraud 2024 - A Report to the Nations, https:// www.acfe.com/-/media/files/acfe/ pdfs/rttn/2024/2024-report-to- the-nations.pdf, letzter Zugriff: 28.04.2026.
4 Schnepf, Jonas; Engin, Tuğranur; Anderer, Simon and Scheuermann, Bernd: Studies on the Use of Large Language Models for the Automation of Business Processes in Enterprise Resource Planning Systems, S. 16-31. In: Natural Language Processing and Information Systems, Lecture Notes in Computer Science Volume 14762, Springer, Cham, Schweiz 2024.
5 Schnepf, Jonas; Schwarz, Matthias; Anderer, Simon and Scheuermann, Bernd: A Study on Multi-agent Collaboration for Business Process Automation in Enterprise Resource Planning Systems, S. 118-138. In: Computational Intelligence, Communications in Computer and Information Science Volume 2827, Springer, Cham, Schweiz 2026.
6 Schnepf, Jonas; Scheuermann, Bernd and Vetter, Paula: Analyzing Data Sets for ML-driven Fraud Detection in SAP Systems, S. 3314-3324. In: Proceedings of IEEE International Conference on Big Data, Sorrento, Italy 2023.
Autoren
Jonas Schnepf, M.Sc.
Akademischer Mitarbeiter am Institut für Angewandte Forschung der HKA, im Projekt SeLLMa
Prof. Dr. Bernd Scheuermann
Projektleiter des Projekts SeLLMa und Professor für Wirtschaftsinformatik an der Fakultät für Wirtschaftswissenschaften
Milliarden durch interne Betrugsfälle.